Nejčastější otázka, kterou dostáváme: proč mi dochází limit, když jsem skoro nic nedělal? Odpověď většinou není v tom, co po Miládce chcete, ale v tom, jak AI funguje a jak dlouhá je konverzace, ve které s ní mluvíte. Šetrnosti jsme věnovali desítky hodin. Tady je, co jsme změřili a co s tím děláme.
Karel DerflClaude čte pokaždé všechno
Claude si mezi odpověďmi nic nepamatuje sám od sebe. Aby vám mohl odpovědět, přečte si pokaždé znovu celou konverzaci od začátku: pravidla Miládky, všechno, co jste si napsali, i všechno, co mezitím přečetl v souborech a v poště.
Limit předplatného se počítá podle toho, kolik textu Claude přečte a napíše. Měří se v tokenech, token je zhruba kousek slova.
Text, který Claude četl nedávno, má odložený a podruhé ho přečte mnohem levněji. Levněji ale neznamená zadarmo, a když je konverzace dlouhá, čte se toho hodně.
Kde to uvidíte
Vedle výběru modelu dole v okně je malé kolečko. Když na něj najedete, ukáže, jak dlouhá je konverzace a kolik jste vyčerpali z limitů.
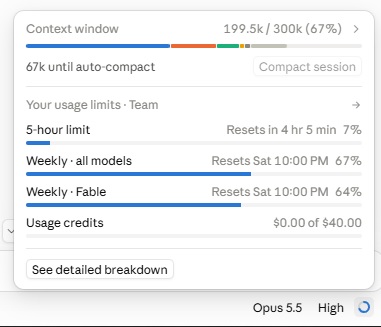
- Context window je délka konverzace. Na snímku skoro 200 tisíc tokenů z 300 tisíc, při kterých se konverzace sama zhustí.
- 5-hour limit se obnovuje po pěti hodinách.
- Weekly je týdenní limit. Ten dochází spíš.
Miládku stavíme tak, aby šetřila
Většinu toho, co Miládka umí, by šlo postavit i jednodušeji: nechat AI, ať si všechno hlídá a čte sama. Funguje to, jenže limit pak mizí, i když se nic neděje. My jsme šli delší cestou. Každou část jsme stavěli a měřili znovu, dokud AI nedělala jen to, na co je AI opravdu potřeba, a strávili jsme nad tím desítky hodin. Kde stačí obyčejný program, AI schválně vynecháváme.
- Hlídání pošty bez AI. Na poštu se dívá malý program v počítači, klidně každých pár minut. Miládku probudí, jen když něco přijde. Když nikdo nenapíše, z limitu nevezme nic. Kdyby poštu kontrolovala AI sama, stála by každá prázdná kontrola v dlouhé konverzaci přes milion tokenů. U nás to dřív bylo dvaadvacetkrát denně.
- WhatsApp stejně. Zprávy hlídá program, Miládka se probouzí jen kvůli skutečné zprávě.
- Hotové se znovu nečte. Co Miládka v poště prošla, dostane štítek a příště ho program rovnou vynechá. Miládka tak nečte pořád dokola celou schránku, ale jen to, co je nové.
- Jedním krokem místo čtyřiceti. Když Miládka po průchodu označuje čtyřicet mailů, udělá to najednou. Každý krok navíc by znamenal číst celou konverzaci znovu.
- Co umí program, dělá program. Podpis do mailu vkládá program a zálohu dělá taky program. AI na to nesahá, takže to z limitu nic nebere.
- Hlídá jen, když má smysl. Pošta se dá hlídat třeba jen v pracovní době.
- Krátká pravidla. Pravidla se čtou u každé odpovědi, takže každá věta navíc se platí pořád dokola. Píšeme je proto co nejkratší a co není potřeba pořád, třeba jak psát mail, se načte až ve chvíli, kdy Miládka mail píše.
- Konverzaci zhustí sama. Když konverzace naroste zhruba na třetinu toho, co Claude unese, Miládka ji shrne. Co je důležité, zůstane v poznámkách, zbytek se zkrátí.
Výsledek je, že Miládka čerpá limit jen tehdy, když opravdu pracuje. Když se nic neděje, nečerpá.
Co z limitu bere nejvíc
Stejnou práci s poštou a poznámkami jsme dali sedmkrát různým modelům a změřili, kolik čeho přečetly a napsaly. Jak dopadly v kvalitě, je v článku Který model na Miládku. Spotřeba se rozdělila takhle:
- Začátek konverzace. Pravidla a popisy nástrojů, které se načtou, ještě než napíšete první slovo. U nás 80 až 130 tisíc tokenů a u krátké práce víc než polovina celé spotřeby. V dlouhé konverzaci se to rozpustí.
- Počet kroků. Každé otevření mailu nebo souboru je krok a každý krok znovu čte celou konverzaci. Model, který udělal třicet kroků místo dvanácti, přečetl víc než třikrát tolik.
- Psaní odpovědí. Znatelné, ale ze tří položek nejmenší.
Víc přemýšlení bere víc hlavně kvůli krokům. Claude pak nejen víc píše, ale hlavně víc věcí ověřuje a otevírá. Proto ho na běžnou práci nepotřebujete.
Přepnutí modelu načte konverzaci znovu
Každý model má text odložený zvlášť. Když v rozjeté konverzaci přepnete na jiný, musí si ji celou načíst znovu. Změřili jsme to v konverzaci dlouhé asi 126 tisíc tokenů: první odpověď po přepnutí načetla skoro sto tisíc tokenů nově, běžná odpověď načítá pár stovek.
Platí se to jednou, další odpovědi už jedou normálně. Návrat na původní model do hodiny skoro nic nestojí a změna úrovně přemýšlení taky ne.
Model tedy měňte po /compact nebo v nové konverzaci, kdy je konverzace krátká.
Limit je jeden na celý účet
Čerpají z něj všechny vaše konverzace s Claude, nejen Miládka. Když vedle ní pracujete na něčem dalším, ubývá limit oběma.
Chytřejší model čerpá limit rychleji, i když udělá stejnou práci. Kolik přesně, Anthropic nezveřejňuje. Pořadí je ale jasné: Haiku nejméně, pak Sonnet, Opus a nejvíc Fable. Fable má u některých předplatných navíc vlastní týdenní limit, na snímku nahoře je to řádek „Weekly · Fable".
Co můžete udělat vy
- Po velké práci
/compact. Napište ho do chatu a konverzace se hned zhustí. Hodí se po dlouhém úklidu, zpracování dokumentů nebo velkém hledání. - Novou konverzaci kvůli limitu nezačínejte. Zhuštění stačí. Nová konverzace znovu načte pravidla a na chvíli zastaví hlídání pošty a WhatsAppu, naběhne až s vaší první zprávou.
- Model měňte na začátku, ne uprostřed. Nejlíp hned po
/compact. - Na běžnou práci běžné přemýšlení. Víc přemýšlení nechte na úklid a složité věci.
- Nedávejte Miládce všechno najednou. Obří soubor nebo stovky mailů naráz zůstanou v konverzaci. Radši po částech.
- Hlídání jen tam, kde ho potřebujete. Každé probuzení čte celou konverzaci. Budit Miládku kvůli každé zprávě ze všech skupin se nevyplatí.
Proč mi dochází limit, i když skoro nic nedělám?
/compact.